算法只占两成,剩下八成才是客户真正买单的东西
有一次销售带客户来公司看设备演示,客户在检测机前站了十来分钟,突然问了一句:“你们这个算法是自己写的吗?”我回答说核心算子自研,部分功能基于开源库封装。客户听完点了点头,又摇了摇头,说了一句让我记到现在的话:“我不管谁写的,我就想知道,产线上的小伙子能不能用明白。”
那一刻我突然意识到,客户嘴上问的是算法,心里关心的其实是产品。这个落差,几乎是机器视觉行业里最常见也最致命的认知错位。
【算法是发动机,产品才是整辆车】
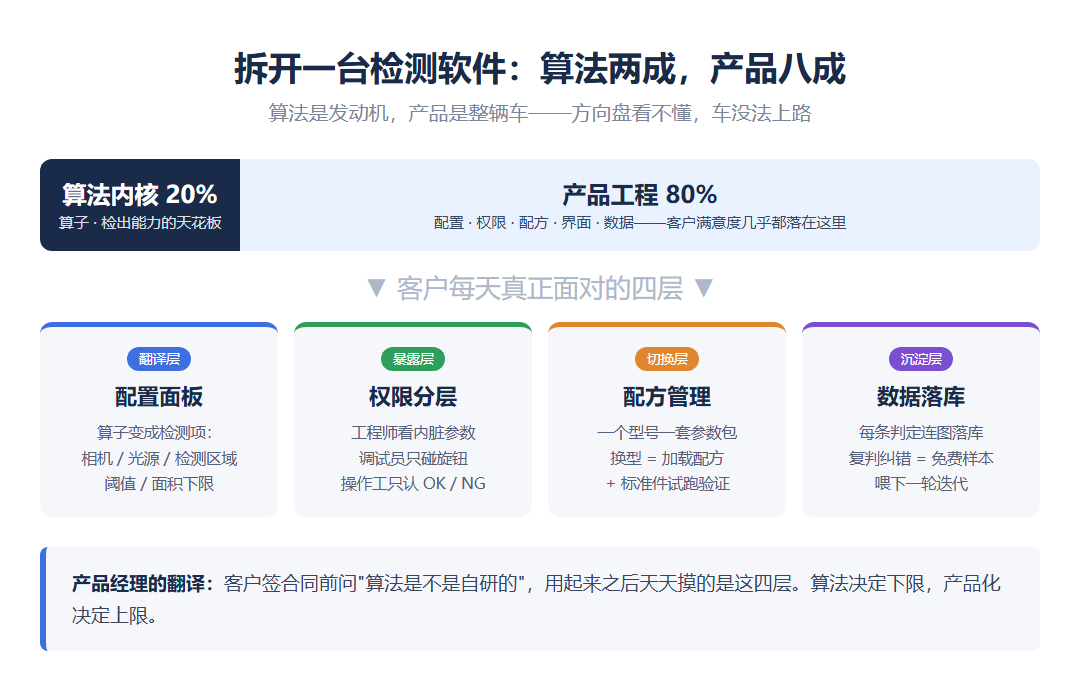
拆过自家检测软件,也看过两三家同行的演示系统之后,我得出一个不太精确但基本靠谱的判断:算法内核大约只占整个系统工作量的两成,剩下八成全是配置、权限、配方、界面、数据这些“不太像技术”的技术活。而客户的满意度,几乎全部落在那八成里。
这个比例其实不只在机器视觉领域成立。放到更广义的办公自动化和AI应用场景中,逻辑是一样的。一个团队花大力气训练了一个精度很高的模型,结果部署到业务侧没人会用,参数不知道怎么调,异常不知道怎么处理,最后模型被束之高阁。问题不出在模型本身,出在从能力到产品之间那段没人愿意干的脏活累活。
算法决定了系统的下限,但产品化决定了上限。发动机再好,方向盘设计得让人看不懂,这辆车还是上不了路。
【把算子翻译成人话,是产品经理的核心价值】
算法工程师跟我聊的是blob分析、边缘提取、模板匹配、频域滤波;客户跟我聊的永远是三句话:这个划痕能不能检?最小能检多小?换了产品还准不准?

这两套语言之间的翻译工作,就是产品经理存在的意义。
拿划痕检测来举例。算法侧看到的可能是“灰度梯度加形态学再叠面积过滤”的组合逻辑;但到了产品侧,它必须变成一个具体的检测项,挂在某个工位下面,带着自己的配置面板:用哪台相机、开哪个光源通道、检测区域框在哪、判定阈值给多少、面积下限设多小。
这个面板上的每一个参数,对算法工程师来说可能只是一个可以随意调整的变量,但对产线操作员来说,是一个他必须理解并且正确设置的决策点。如果产品设计者不去做这层翻译,操作员面对的就是一堆他看不懂的数字,误操作几乎是必然的。
这里有一个很实用的设计原则:用三层用户体系来隔离复杂度。管理员负责系统级配置,工程师负责配方和参数调优,操作员只看到“开始检测”和“合格不合格”两个按钮。再用配方管理把不同产品的检测方案打包固化,切换产品时一键调用,而不是让人重新调一遍参数。这本质上和办公自动化里做流程模板、做权限分级是同一套思路。
【公差不是技术指标,是商业条款】
很多技术团队把公差当成一个纯粹的工程参数来对待,追求越小越好、越严越安全。但从产品视角看,公差其实是一个商业条款。
你把公差定得太松,客户觉得你检测能力不行;定得太严,误报率飙升,产线频繁停机复检,客户照样不满意。真正合理的公差,是在漏检率和过杀率之间找到一个客户能接受的平衡点,而这个平衡点往往不是技术最优解,而是商业最优解。
更关键的是,公差一旦确定,它就成了交付合同的一部分。设备验收时按什么标准判定合格,出问题时按什么标准追溯责任,这些都要在参数层面固化下来,而不是留在某个工程师的脑子里。
【复检数据是最被低估的资产】
大多数检测设备交付之后,复检环节产生的数据就被浪费掉了。操作员复检完,标记一下合格或不合格,数据往数据库里一扔,再也没有人看过。
但这些复检数据其实是模型迭代最宝贵的燃料。每一次人工复检,本质上都是对算法判断的一次标注。哪些被算法判为缺陷但人工确认没问题的,是过杀样本;哪些被算法放行但人工发现问题的,是漏检样本。这两类数据积累到一定量级,就是优化模型最有针对性的训练素材。
把复检数据反哺模型迭代这件事,技术难度并不高,难的是产品设计时有没有预留这条数据通路。如果检测软件在设计之初就没有考虑复检数据的结构化采集和回流机制,后期再想补,成本会高得多。
【结语】
回到开头那个客户的问题。他问的是算法,但他真正想确认的是:这个东西到了我的产线上,我的人能不能用得起来。
这个问题不只属于机器视觉行业。任何把AI能力落地到业务场景的团队,都会面对同样的拷问。模型精度再高,如果参数面板让人一头雾水,如果公差设定脱离业务实际,如果复检数据白白流失,那这个系统就永远停留在演示阶段,无法真正产生价值。
把算法做成产品,不是降级,而是升维。它要求我们不仅懂技术,还要懂使用技术的人,懂他们面对的约束和决策场景。这件事没有捷径,但每一步都值得。