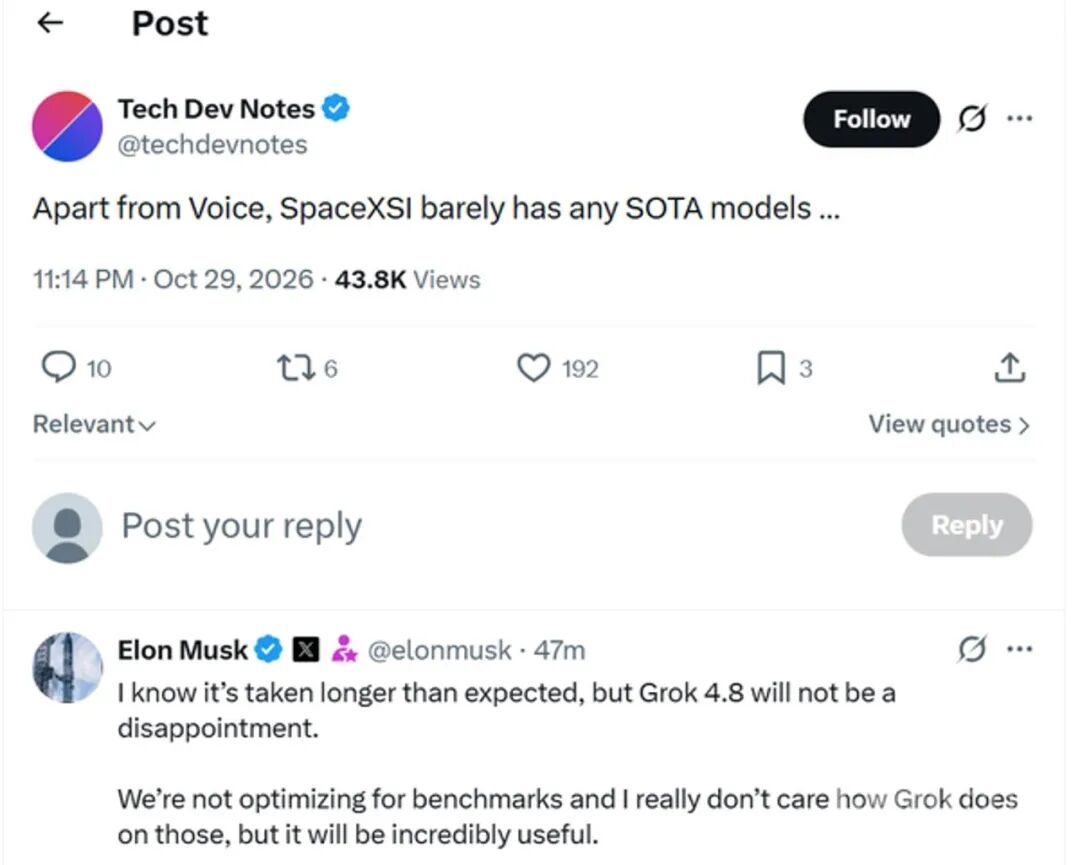
马斯克最近在社交平台上回应了Grok 4.8延期发布的消息,大意是:比预期久了一些,但不会让人失望,而且他并不在意跑分。这句话看似轻描淡写,却戳中了当下AI行业一个越来越明显的矛盾——我们到底该用什么标准来衡量一个模型或工具的好坏?
对于办公自动化领域的从业者和使用者来说,这个问题尤其值得深挖。因为办公场景恰恰是那种“跑分再高,干不完活也白搭”的典型环境。
【跑分文化的局限:榜单上的高分不等于桌面上的效率】
模型发布越来越像一场倒计时狂欢:参数量、上下文窗口、各类Benchmark分数先被反复讨论,真正能不能把一项工作从头到尾做完,反而要等模型进入真实环境后才见分晓。这种错位在办公自动化场景中尤为致命。
一个在数学推理榜单上名列前茅的模型,未必能可靠地帮你从二十封邮件里提取出待办事项并归类到正确的项目文件夹。一个代码生成分数很高的模型,也未必能稳定地调用你的日历API、文档系统和审批流程。办公自动化的核心诉求从来不是“单点能力最强”,而是“端到端流程跑得通”。
马斯克说不在意跑分,本质上是在强调:真实问题解决能力才是产品的终极指标。这个逻辑放在办公自动化工具的选择和评估上,完全成立。
【Agent验收的四个务实维度】
与其盯着榜单等一个新模型发布,不如提前建立一套面向真实业务的验收框架。结合办公自动化的实际需求,我认为可以从四个维度来考察一个AI Agent是否合格。
第一,任务完成度。需求是否被真正交付,而不是只生成一段看似合理的回答。在办公场景中,这意味着:会议纪要是否准确提炼了决策项和责任人?报销单据是否被正确分类并填入了对应字段?周报是否基于真实数据生成而非泛泛而谈?衡量指标应该是端到端成功率和人工返工率,而不是“回答看起来像不像”。
第二,工具调用的可靠性。办公自动化的本质是让AI代替人去操作各种系统——搜索、邮件、日历、数据库、浏览器、内部OA。Agent能否正确选择工具、参数是否准确、是否存在大量无效调用,这些直接决定了自动化流程能不能上线。一个工具调用成功率只有七成的Agent,在办公场景中几乎不可用,因为剩下三成的失败需要人工兜底,反而增加了工作量。
第三,失败恢复能力。真实办公环境远比测试集混乱:接口超时、权限不足、数据格式异常都是常态。Agent在失败后能否识别问题、尝试替代方案或清晰地向人求助,比它一次成功的概率更重要。一个不会“体面地失败”的Agent,在生产环境中就是一颗定时炸弹。
第四,成本可控性。办公自动化往往涉及高频、重复的任务调用,Token消耗和API费用会快速累积。一个单次任务成本过高的方案,即使准确率再高,也很难在日常办公中规模化推广。
【对办公自动化从业者的启示:把模型当可替换零件】
Grok 4.8尚未正式发布,网络上流传的参数规模、技术栈和训练计划都只能作为待确认信息看待。这对办公自动化从业者其实是一个提醒:不要把系统架构绑定在某个具体模型的承诺上。
更稳妥的做法是,把业务任务抽象成可替换的模型调用层,用固定的数据集和固定的工具权限来评估每一个新版本。模型名称、接口、上下文限制和价格都可能在正式发布前变化,但你的业务流程和验收标准应该是稳定的。这样无论下一个“最强模型”是谁,你都能快速判断它是否真的让你的办公流程更快、更准、更省心。
【总结】
跑分是实验室里的语言,效率是办公室里的语言。两者之间隔着一整套真实的工具链、异常处理和成本约束。马斯克对Grok 4.8的表态,与其说是一次产品预热,不如说是一次提醒:在AI应用越来越深入的今天,验收标准应该从“它考了多少分”转向“它替我干完了多少活”。对于办公自动化而言,这个转向不是选择题,而是必答题。