有人问我怎么从写代码的变成一个做出百万播放AI视频的人,我想了想,答案其实特别朴素:审美积累。
但这句话说起来轻巧,做起来要命。看到一段好看的视频,你得愿意花积分去复现它。复现多了,你才会慢慢摸到分镜的门道,知道哪个模型适合做人脸,哪个适合做动作,什么样的提示语能让角色保持一致,色彩和画风又该怎么搭配。
问题是,第一步就筛掉了绝大多数人。现在的AI视频生成,几乎没有谁觉得便宜。运气好的时候一发入魂,运气差的时候连抽十次全是废片。这种体验,跟赌博没什么区别。
最近看到一个很有意思的开源项目,作者花了将近一个月时间,真金白银把463条AI视频提示语全部重新跑了一遍,最终产出14个覆盖各类视频场景的提示语模版和25个视频生成Skills,全部开源。光抽卡就烧了两万块,这个月基本没怎么睡。
这件事让我想到几个值得聊的问题。
【提示语合集满天飞,为什么还要再做一个】
网上AI提示语的合集网站其实不少,但作者提到一个很关键的痛点:质量参差不齐,没有统一打分,有的连分类都没有。你在上面翻半天,还不如直接去社交平台随机搜几条。更麻烦的是,每次测试新模型的时候,如果都用固定的那几条提示语,根本测不出模型的上限。
这其实是办公自动化领域一个很常见的困境。工具多了,素材多了,但筛选和验证的成本反而更高了。我们缺的不是信息,而是经过验证的、可以直接拿来用的信息。
这个项目的思路是:每一条提示语都经过实测复现,有打分,有分类。你找到自己喜欢的风格,拿走模版改几个词就能用。这个逻辑,跟我们在办公场景中建立标准化流程是一样的——先验证,再沉淀,最后变成可复用的资产。
【视频复现为什么比图片难那么多】
做过AI绘画的人都知道,图片生成的可控性已经相对成熟了。但视频不一样。一条视频涉及的不只是画面,还有时间维度上的连贯性、角色一致性、动作流畅度、镜头语言。任何一个环节出问题,整条视频就废了。
这也是为什么作者要动用多个多模态模型来做自动化打分和聚类。人工一条条看,根本看不过来。用AI来评估AI的产出,再结合自动收录机制,从代码托管平台、短视频平台、社交平台上抓取带提示语的案例,这套流程本身就是一个典型的办公自动化思路:把重复性的筛选、分类、评估工作交给机器,人只负责最终的判断和创作。
【对普通创作者意味着什么】
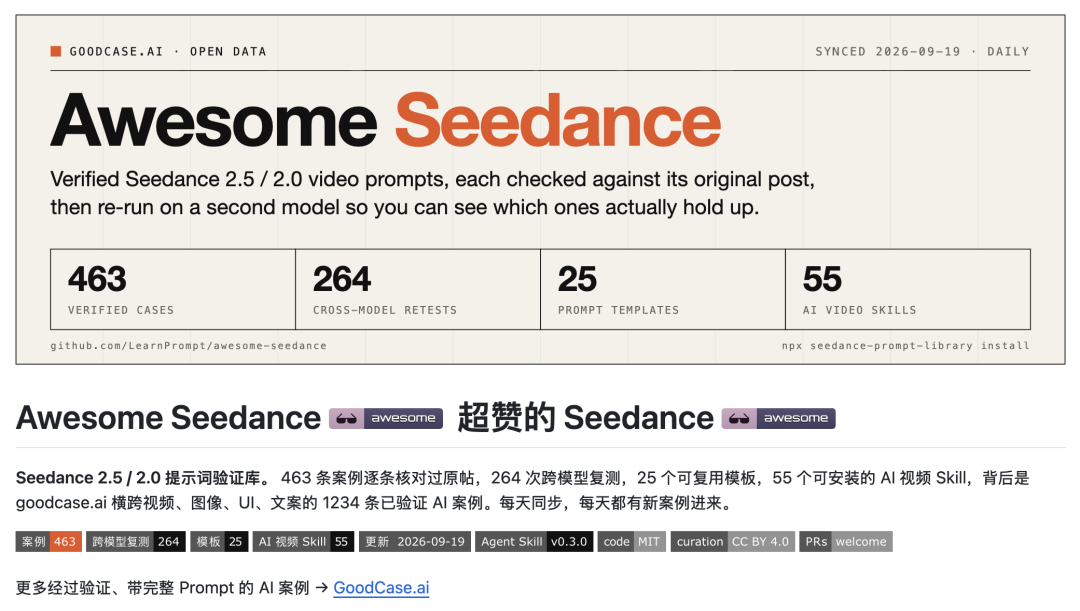
我觉得这个项目最大的价值不在于463这个数字,而在于它建立了一套可参考的标准。
以前你想学AI视频,路径是这样的:刷到好看的视频,截图,猜提示语,自己试,失败,再试,直到积分烧完。现在你有了一个经过验证的起点,可以跳过大量无效试错。
这跟我们做办公自动化的逻辑完全一致。一个好的自动化流程,不是替你干活,而是替你跳过那些已经被验证过的坑。
当然,提示语模版只是起点。真正的审美积累,还是得靠自己去感受、去拆解、去练习。但至少,你不用再从零开始一个人抽卡了。
【总结】
AI视频的门槛正在从“会不会写提示语”转向“有没有经过验证的方法论”。开源社区里有人愿意花两万块和一个月的时间去蹚路,这件事本身就值得尊重。对于普通创作者来说,与其自己盲目抽卡,不如先学会站在别人的验证结果上起步。效率提升的本质,从来不是做得更快,而是少走弯路。