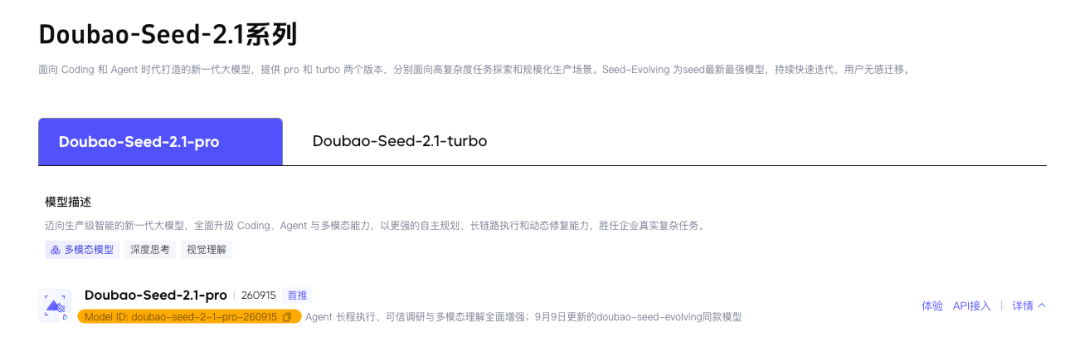
过去一年,我们见证了AI从「能聊天」快速进化到「能干活」。但真正让办公场景发生质变的,并不是模型能写多漂亮的文案,而是它能不能看懂一张图、理解一份表格、然后自己把一整套流程跑完。最近豆包旗下的Seed-2.1-pro更新了0915版本,把重心压在Coding、Agent和多模态三件事上,恰好击中了这个关键命题。
【从「看懂」到「做出来」才是真本事】
多模态能力这两年并不新鲜,很多模型都能描述图片内容。但描述和落地之间隔着一道鸿沟。比如你给AI一张展厅平面草图,加上27件作品的编号总览和配套资料,让它做一个可拖拽浏览的三维电子展馆——这需要的不仅是识别草图上的线条和文字,还要理解空间关系、展区划分、动线设计,再把每一件作品挂到正确的位置上,配上对应的展签和灯光。
这本质上是一个「视觉理解+长程任务规划+代码执行」的复合任务。模型得先读懂平面图里入口在哪、隔墙怎么分布、三个展区如何衔接,然后核对配套表格里的坐标数据,最后生成一个真正能在浏览器里跑起来的三维场景。任何一步掉链子,最终结果都对不上号。
我认为这才是多模态能力真正有价值的检验标准:不是能不能说出图里有什么,而是能不能基于图里的信息把东西做出来。
【Agent的「长程不掉线」比单点聪明更重要】
另一个值得关注的维度是Agent在长程任务中的表现。所谓长程任务,就是步骤多、依赖关系复杂、中间需要反复调用工具和核对信息的任务。办公场景里这类任务比比皆是:整理一份跨部门的季度报告、根据合同模板批量生成个性化文档、把一堆散乱的会议记录整理成结构化待办事项。
这些任务的难点不在于每一步有多难,而在于步骤一多就容易「糊弄」——模型可能跳步、可能忘记前面的约束条件、可能在调用工具后没有正确使用返回结果。Seed-2.1-pro这次把Agent能力作为升级重点,说明厂商也意识到了这个问题的重要性。
从实际表现来看,当模型能够按照「先读平面图和总览→梳理展区和动线→核对坐标文件→标注展位→生成场景」这样的顺序自主推进时,它就不再是一个需要你步步指挥的工具,而更像一个能独立完成项目的协作者。这对办公效率的提升是数量级的。
【对办公自动化的三个启示】
第一,多模态输入正在成为办公自动化的标配。现实中大量的办公信息不是纯文本——设计稿、流程图、扫描件、白板照片、数据截图,这些才是日常工作的真实形态。一个只能处理文字的AI,在办公场景里的天花板很低。
第二,Agent的价值在于「自己推进」。如果每个步骤都需要人工确认和引导,那和传统软件的操作没有本质区别。真正的自动化应该是你给出目标和约束条件,AI自己规划路径、调用工具、检查结果、修正错误。
第三,Coding能力是连接理解和执行的桥梁。理解了一张图、规划好了步骤,最终要落地成一个可运行的东西——无论是网页、脚本还是自动化流程——都需要代码生成能力来兜底。这也是为什么Coding、Agent、多模态这三件事必须一起看,它们构成了一个完整的「感知-决策-执行」闭环。
【总结】
Seed-2.1-pro的这次更新,与其说是一次版本迭代,不如说是在释放一个信号:AI在办公场景中的角色,正在从「辅助写作」转向「独立执行」。当模型能看懂图纸、能自己规划步骤、能把想法变成可运行的产品时,办公自动化的想象空间就被彻底打开了。
对于普通办公用户来说,这意味着你可以把更复杂的任务交给AI,而不只是让它帮你润色一段文字。对于企业和团队来说,这意味着重新思考哪些工作流程可以被端到端地自动化。而对于AI产品本身来说,谁能把多模态理解、长程规划和代码执行这三件事真正打通,谁就能在下一阶段的办公自动化竞争中占据先机。